Cerebras Au Disrupt 2026 Sur Le Scaling De L’Ia
Et si la prochaine frontière de l'intelligence artificielle n'était plus un modèle plus grand, mais simplement la possibilité physique de le faire tourner ? Chaque génération de systèmes gagne en capacité, et chaque bond exige davantage de calcul, d'électricité et d'usines. La question n'est plus seulement théorique : elle occupe désormais les fondateurs, les investisseurs et les opérateurs de centres de données. À San Francisco, lors de TechCrunch Disrupt 2026, Andrew Feldman, cofondateur et directeur général de Cerebras Systems, vient poser ce dilemme sur scène.
Peut-On Encore Faire Grandir L'Ia Sans Casser Le Système
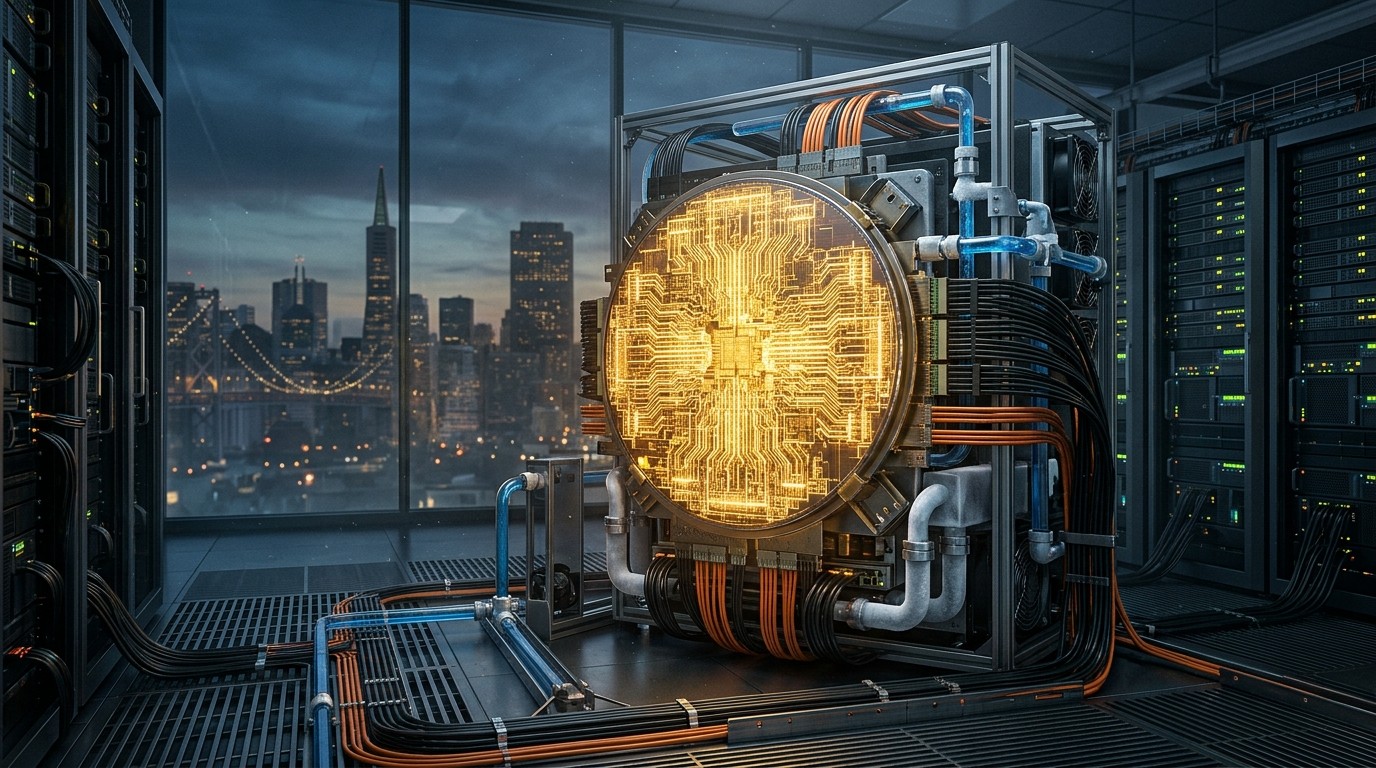
Les modèles progressent. Les besoins aussi. Derrière les démonstrations spectaculaires se cache une mécanique brutale : plus de paramètres, plus de tokens, plus de mémoire, plus de refroidissement. Les architectures classiques de puces, découpées en petits dies puis assemblées, ont longtemps paru incontournables. Cerebras a choisi une autre voie, celle du wafer-scale computing, un processeur construit à l'échelle de la galette de silicium entière plutôt que découpé en morceaux.
Cette décision n'est pas un gadget marketing. Elle vise un goulot d'étranglement que beaucoup considéraient comme une fatalité industrielle. Quand le calcul devient trop fragmenté, les échanges entre puces coûtent du temps et de l'énergie. Un wafer unique cherche à réduire cette friction. L'idée paraît simple. La mettre en production l'est beaucoup moins.
La question n'est plus seulement de concevoir un processeur plus rapide. Il faut assez d'infrastructures physiques pour le mettre réellement au travail.
– Synthèse des enjeux présentés autour de la session « Can AI Keep Scaling ? »
Un fondateur habitué aux paris d'infrastructure
Andrew Feldman n'arrive pas sur la scène de Disrupt comme un nouvel arrivant fasciné par la dernière vague générative. Il a cofondé Cerebras en 2015, après avoir déjà construit des entreprises autour de l'infrastructure informatique. Avant cela, il avait dirigé SeaMicro, spécialisée dans les microserveurs économes, rachetée par AMD en 2012. Plus tôt encore, il avait occupé des responsabilités chez Force10 Networks et Riverstone Networks.
Ce parcours compte. Il explique pourquoi l'entreprise n'a pas seulement dessiné une puce atypique : elle a accepté de se battre contre des habitudes industrielles très ancrées. Pendant des années, le wafer-scale passait pour trop fragile, trop cher, trop difficile à refroidir et à produire. Feldman et ses cofondateurs ont tenu ce pari assez longtemps pour le confronter enfin à une demande explosive de compute IA.
Pourquoi le wafer-scale change la conversation
Dans une approche classique, on découpe le silicium, on teste, on assemble, on relie. Chaque liaison devient un pont. Plus le modèle est large, plus ces ponts saturent. Cerebras inverse le geste : le processeur reste sur le wafer. L'architecture vise des charges d'entraînement et d'inférence particulièrement lourdes, là où la communication interne devient un facteur décisif.
Cela ne signifie pas que la puce magique résout tout. Une architecture différente déplace les contraintes. Il faut encore de l'énergie, des salles blanches, des contrats d'électricité, des équipes capables d'installer et d'exploiter. Le discours de Feldman à Disrupt insiste précisément sur ce point : le hardware n'est qu'une pièce du puzzle. Sans capacité de fabrication et sans mégawatts disponibles, l'innovation reste une maquette.
Les fondateurs qui écoutent cette session ne viennent pas seulement pour admirer une architecture. Ils viennent comprendre si un chemin alternatif peut tenir quand les files d'attente chez les fondeurs s'allongent et que les réseaux électriques locaux saturent. Le timing n'est pas anodin. L'IA n'est plus une expérience de laboratoire. Elle est devenue une question d'approvisionnement.
Des chiffres qui transforment un pari technique en enjeu industriel
Cerebras a levé 5,5 milliards de dollars lors de son introduction en Bourse au mois de mai. Ce n'est pas un détail financier isolé. Cela donne à l'entreprise les moyens d'accélérer la production au moment où la demande de calcul explose. Un accord pluriannuel avec OpenAI prévoit le déploiement de 750 mégawatts de systèmes Cerebras entre 2026 et 2028. En août, la société a présenté le CS-4, dernière génération de son infrastructure wafer-scale.
Au même moment, l'entreprise affirmait disposer de plus de 600 mégawatts de capacité de data centers déjà en service ou sous contrat pour une livraison d'ici fin 2027. Elle indiquait aussi multiplier sa capacité de fabrication par plus de dix au cours de 2026. Côté Europe, un premier site doit entrer en ligne cette année, avec une ambition de 200 mégawatts d'ici la fin 2027.
- Une introduction en Bourse de 5,5 milliards de dollars pour financer l'industrialisation.
- Un engagement de 750 mégawatts avec OpenAI entre 2026 et 2028.
- Plus de 600 mégawatts de capacité de centres de données visés d'ici fin 2027.
- Une montée en cadence manufacturière multipliée par plus de dix en 2026.
- Une première capacité européenne, puis 200 mégawatts à l'horizon 2027.
Ces volumes parlent un langage que les seuls passionnés d'architecture de puces ne maîtrisent pas toujours. Ils disent que le goulot d'étranglement a quitté la salle de conception pour rejoindre le terrain : permis de construire, transformateurs, eau de refroidissement, chaînes d'approvisionnement, formation des équipes. Scaler l'IA, c'est scaler une économie matérielle.
L'énergie, le vrai juge de paix
On peut discuter indéfiniment de la taille d'un modèle. On ne discute pas avec un réseau électrique saturé. Les processeurs plus puissants n'effacent pas le besoin de data centers, d'électricité et de refroidissement. Cerebras le reconnaît en exposant ses propres contrats de capacité. C'est une manière de dire que l'avantage compétitif ne viendra plus seulement d'un benchmark de performance, mais de la capacité à livrer des mégawatts utilisables à temps.
Cette réalité change le profil des conversations à Disrupt. Les fondateurs présents ne se demandent plus seulement comment entraîner un modèle. Ils se demandent où le brancher. Les investisseurs, eux, regardent les délais de raccordement autant que les feuilles de route produits. Un hardware brillant qui attend deux ans une sous-station n'est plus un atout. C'est un stock immobilisé.
Le discours de Feldman s'inscrit dans cette bascule. Il ne s'agit pas de proclamer que le wafer-scale gagne à tous les coups. Il s'agit de montrer qu'une autre architecture peut, ou non, alléger certaines frictions au moment où les architectures conventionnelles commencent à buter sur leurs propres limites de densité, de communication interne et de coût énergétique.
Ce que la session de Disrupt change pour les décideurs
La conférence se tient du 13 au 15 octobre au Moscone West, à San Francisco. Plus de 10 000 fondateurs, investisseurs, opérateurs et dirigeants y sont attendus, avec plus de 250 intervenants, 200 sessions et 300 startups exposantes. Dans ce paysage bruyant, la session « Can AI Keep Scaling ? » a le mérite d'être concrète. Elle relie une question philosophique — jusqu'où l'IA peut-elle grandir — à des contraintes mesurables.
Pour un fondateur, l'intérêt n'est pas de copier Cerebras. Il est de comprendre où se situent les vrais plafonds. Faut-il optimiser les modèles pour consommer moins ? Faut-il diversifier les fournisseurs de calcul ? Faut-il rapprocher l'entraînement des sources d'énergie ? Faut-il accepter que certaines ambitions de modèles géants deviennent trop chères à tenir ? Ces questions ne relèvent plus du débat académique.
Pour un investisseur, le récit change aussi. Une startup hardware n'est plus seulement évaluée sur son originalité scientifique. Elle l'est sur sa capacité à signer des contrats d'infrastructure, à monter en cadence et à survivre à des cycles d'approvisionnement longs. Le cas Cerebras sert alors de laboratoire : une entreprise née avant le boom actuel, qui doit maintenant livrer à l'échelle de la demande.
Les limites du hardware classique ne sont plus une abstraction
Pendant longtemps, la réponse à la croissance de l'IA a été simple : plus de GPU, plus de clusters, plus de parallélisme. Cette stratégie a fonctionné. Elle continue de fonctionner. Mais elle rencontre des frottements visibles. Les interconnexions coûtent cher. La consommation grimpe. Les délais de fabrication s'étirent. Les territoires capables d'accueillir de nouveaux campus se raréfient.
Le wafer-scale n'efface pas ces frottements. Il en déplace certains. En concentrant davantage de calcul sur une surface continue, Cerebras cherche à réduire le prix de la communication interne. Reste à prouver, à grande échelle et dans la durée, que cette promesse tient face aux aléas de production, de maintenance et d'intégration logicielle. C'est précisément ce que la session de Feldman invite à examiner, sans folklore.
Scaler l'intelligence artificielle, ce n'est plus seulement inventer un algorithme plus habile. C'est réussir à lui donner un corps industriel.
– Lecture des enjeux d'infrastructure autour de Cerebras
Ce que les équipes techniques devraient retenir
Les équipes qui déploient des modèles aujourd'hui jonglent déjà avec des arbitrages peu glamour : latence contre coût, taille de contexte contre mémoire disponible, entraînement centralisé contre inférence distribuée. L'arrivée d'architectures alternatives force à revoir ces équilibres. Un cluster n'est plus un objet interchangeable. Le software doit épouser le hardware, et non l'inverse.
Cela a une conséquence pratique. Les entreprises qui veulent rester souveraines sur leur stack devront mieux connaître leurs dépendances. Qui fabrique leurs puces ? Où se trouvent leurs watts ? Quel délai sépare une commande d'une mise en production réelle ? Cerebras, en exposant à la fois son architecture et ses capacités physiques, rappelle que la feuille de route d'un modèle n'a de valeur que si l'infrastructure suit.
- Cartographier la consommation réelle des entraînements et des inférences.
- Comparer le coût de communication interne des architectures classiques et alternatives.
- Intégrer les délais énergétiques et immobiliers dans les roadmaps produits.
- Ne plus séparer la stratégie modèle de la stratégie d'approvisionnement.
Une leçon plus large pour l'écosystème startup
Le cas Cerebras dépasse le cercle des spécialistes du silicium. Il raconte ce qui arrive lorsqu'une innovation mature au moment où le marché bascule. Pendant près d'une décennie, le wafer-scale a paru exotique. Puis la demande de calcul a explosé, et l'exotisme est devenu une option stratégique. Beaucoup de startups hardware vivent ce décalage : trop tôt, puis soudain trop attendues.
Disrupt aime ces bascules. La conférence n'est pas seulement une vitrine de levées de fonds. C'est un lieu où l'on voit quelles contraintes deviennent soudain visibles. Ici, la contrainte visible s'appelle échelle. Pas l'échelle marketing d'un communiqué. L'échelle des usines, des câbles et des contrats pluriannuels. Celle qui décide si une intuition technique devient une industrie.
On peut être sceptique. On peut estimer que les architectures conventionnelles ont encore de la marge, grâce à de meilleurs interconnects, à des modèles plus efficaces ou à de nouvelles générations de lithographie. Le scepticisme est sain. Il n'annule pas la question posée par Feldman : que se passe-t-il le jour où ces marges ne suffisent plus ?
Le scaling n'est plus un slogan, c'est une géographie
Parler de 200 mégawatts en Europe ou de 750 mégawatts pour un partenaire américain, ce n'est pas seulement aligner des zéros. C'est admettre que l'IA a désormais une carte. Elle s'installe là où l'électricité existe, là où les permis passent, là où les talents d'exploitation peuvent être recrutés. Le cloud donne l'illusion d'un calcul sans lieu. Les contrats de capacité rappellent le contraire.
Cette géographie aura des effets politiques et économiques. Les régions capables d'offrir de l'énergie bas carbone et des délais raisonnables attireront les prochaines vagues d'infrastructure. Les autres regarderont les projets glisser ailleurs. Pour les startups européennes, le signal est double : opportunité de proximité, mais aussi risque de dépendance si la capacité locale reste trop faible.
Feldman n'a pas vocation à régler cette carte à lui seul. Son intérêt, dans le cadre de Disrupt, est de relier une architecture de puce à cette réalité territoriale. Trop souvent, on présente le hardware comme un objet de laboratoire. Ici, il redevient une affaire de sol, de réseau et de calendrier.
Ce qu'il faudra surveiller après la conférence
Une keynote ne prouve rien. Elle oriente le regard. Après Disrupt, trois indicateurs vaudront mieux que les formules de scène. Premier indicateur : la cadence réelle de fabrication du CS-4 et des générations suivantes. Deuxième indicateur : la conversion des mégawatts sous contrat en capacité effectivement livrée. Troisième indicateur : l'adoption logicielle, c'est-à-dire la facilité pour les équipes à porter leurs charges sur cette architecture.
Si ces trois lignes avancent ensemble, le wafer-scale sortira du statut d'exception pour devenir une option crédible dans le mix de calcul. Si l'une d'elles décroche, le récit reviendra à une innovation brillante mais difficile à industrialiser. C'est le destin habituel des ruptures hardware. Elles ne meurent pas d'un mauvais slide. Elles s'essoufflent dans les usines.
Les observateurs auraient tort de réduire le sujet à une rivalité de marques. L'enjeu dépasse Cerebras. Il concerne tous ceux qui parient sur une IA toujours plus capable. Plus les modèles s'élargissent, plus le monde physique rappelle qu'il n'est pas élastique à l'infini. Le calcul a un prix. L'électricité a un prix. Le temps de construction a un prix.
Une conversation à poursuivre loin de la scène
On sortira de cette session avec davantage de questions que de certitudes, et c'est tant mieux. L'IA n'a pas besoin d'un nouveau mythe de croissance infinie. Elle a besoin d'un diagnostic honnête sur ce qui peut encore scaler, à quel coût, et avec quelles architectures. Feldman apporte le point de vue d'un entrepreneur qui a mis dix ans à défendre une idée jugée peu pratique, puis s'est retrouvé au centre de la ruée vers le calcul.
Le public de Disrupt, lui, repartira avec une grille plus nette. Concevoir plus vite ne suffit plus. Financer plus gros ne suffit plus. Il faut aligner puces, usines, watts et logiciels. Les entreprises qui comprendront cet alignement prendront de l'avance. Les autres continueront d'annoncer des modèles que personne ne pourra entraîner à temps.
Alors, l'intelligence artificielle peut-elle continuer à grandir ? La réponse ne tiendra pas dans une punchline. Elle se lira dans les prochains rapports de capacité, dans les raccordements électriques, dans les choix d'architecture et dans la capacité des fondateurs à traiter l'infrastructure comme un produit à part entière. C'est là que le scaling cesse d'être un mot de présentation. Il redevient un métier.