Underdog Présente Woof Un Modèle Vocal Ultra Léger
Et si demain votre téléphone ou votre ordinateur pouvait générer une voix naturelle sans jamais envoyer la moindre donnée vers un serveur ? Alors que les géants de l’intelligence artificielle continuent de construire des modèles toujours plus massifs, une jeune pousse américaine vient de prouver qu’une autre voie existe. Avec un modèle de seulement 32 Mo, Underdog bouscule les codes et rappelle que la performance ne se mesure pas uniquement en milliards de paramètres.
Un modèle de 32 Mo qui tourne dans le navigateur
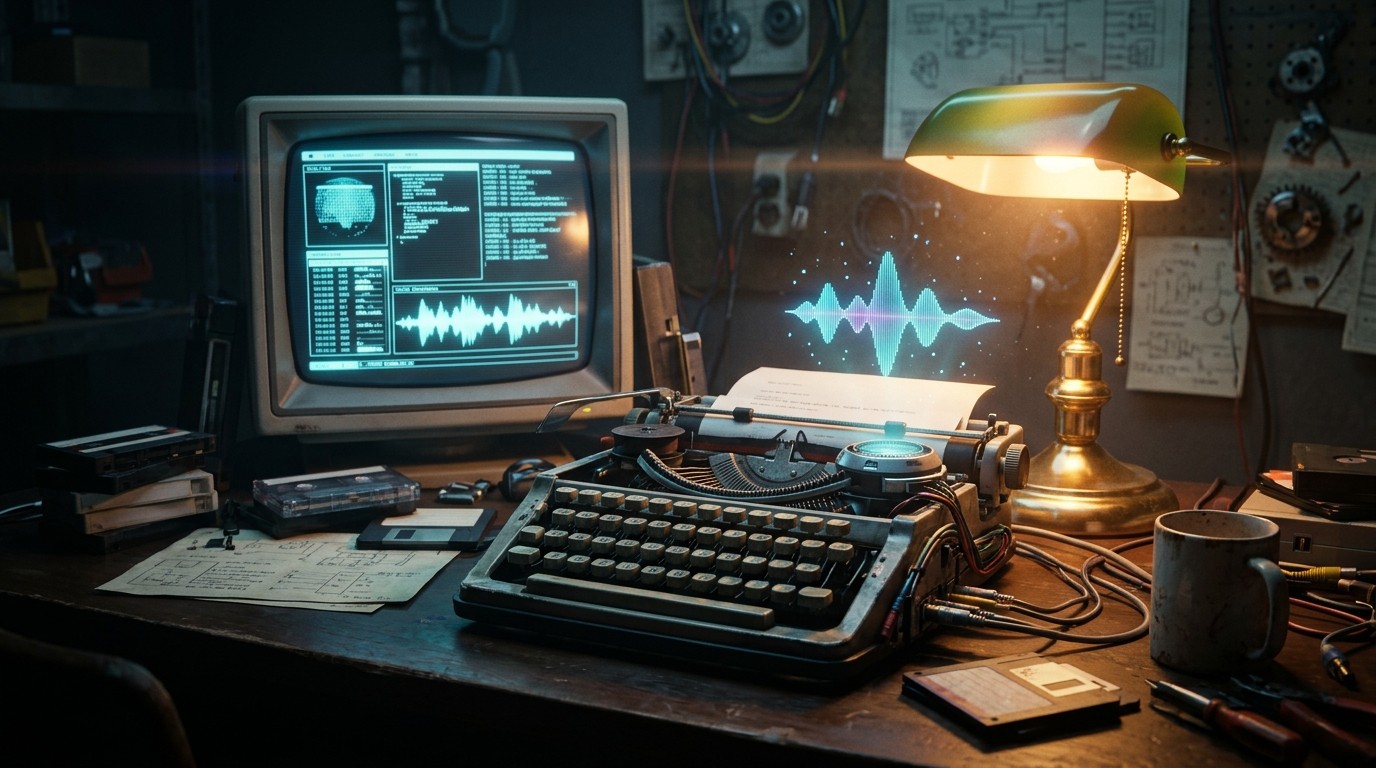
La startup Underdog a récemment présenté Woof, un modèle de synthèse vocale ultraléger. Pesant à peine 31,7 Mo et comptant 31 millions de paramètres, il peut s’exécuter entièrement dans un navigateur web, sans connexion internet. Pour démontrer ses capacités, l’équipe a imaginé un petit jeu interactif à l’ambiance rétro. Le joueur se retrouve dans une pièce meublée d’une machine à écrire, d’un moniteur CRT et d’une lampe de bureau. Chaque interaction déclenche une réponse vocale générée en temps réel par le modèle.
L’expérience est volontairement ironique. Une introduction met en garde contre les « prestataires cloud intrusifs » qui rôdent dans la ville. Un clin d’œil à peine voilé aux solutions d’IA hébergées exclusivement dans le cloud. En tapant n’importe quel texte sur la machine à écrire, l’utilisateur entend immédiatement la phrase prononcée. Un autre élément permet de générer de la musique simplement en tournant un bouton. Le tout tourne localement, prouvant que la taille n’est pas toujours un obstacle à l’utilité.
Pourquoi la légèreté change la donne
La course aux grands modèles a ses limites évidentes. Ces architectures exigent des GPU puissants, consomment énormément d’énergie et nécessitent une connexion permanente. À l’inverse, un modèle de 32 Mo ouvre des perspectives concrètes pour l’IA embarquée. Il devient possible d’imaginer des assistants vocaux privés qui ne quittent jamais l’appareil, des livres audio personnalisés générés à la volée, ou encore des outils de dictée totalement hors ligne.
Sigil Wen, fondateur d’Underdog, résume clairement son ambition. Il explique avoir commencé à développer ces outils parce qu’il souhaitait remplacer les applications de prise de notes cloud par des solutions locales respectueuses de la vie privée. Son objectif est de prouver que les modèles les plus capables d’aujourd’hui pourront bientôt tourner sur les appareils que nous possédons déjà.
Nous voulons entraîner les meilleurs modèles open source américains, capables et permettant aux gens d’avoir une IA privée.
– Sigil Wen, fondateur d’Underdog
Une stratégie cohérente autour de l’IA locale
Woof n’est pas un coup isolé. Quelques semaines plus tôt, la même équipe avait lancé Bark, un modèle de reconnaissance vocale de 167 Mo également conçu pour fonctionner sur appareil. Ensemble, ces deux modèles permettent de créer un pipeline complet de transcription et de synthèse entièrement local. Underdog a également mis à disposition un modèle de langage de 27 milliards de paramètres capable de tourner sur un ordinateur portable classique, ainsi qu’une application en liste d’attente positionnée comme alternative locale à certaines solutions cloud populaires.
Cette approche s’inscrit dans une tendance plus large. De plus en plus de développeurs et d’utilisateurs cherchent des alternatives aux services centralisés. Les raisons sont multiples : respect de la confidentialité, autonomie en l’absence de réseau, réduction des coûts d’inférence et maîtrise des données personnelles. Les modèles légers répondent précisément à ces attentes.
Ce que permet réellement un modèle de 32 Mo
Il serait naïf de croire qu’un modèle de 31 millions de paramètres rivalise avec les systèmes les plus avancés du marché. La qualité de la voix, la naturalité des intonations et la richesse des émotions restent en retrait par rapport aux solutions les plus lourdes. Pourtant, pour de nombreux usages concrets, la différence devient secondaire. Une voix claire, compréhensible et disponible instantanément suffit souvent.
Parmi les applications les plus prometteuses, on peut citer :
- Les assistants personnels qui restent sur l’appareil et ne partagent aucune information.
- La génération de podcasts ou de résumés audio personnalisés sans passer par un serveur distant.
- Les outils d’accessibilité capables de lire un texte à haute voix même hors ligne.
- Les expériences interactives et les jeux qui intègrent de la voix dynamique sans latence réseau.
Dans chacun de ces cas, la légèreté du modèle devient un avantage décisif plutôt qu’un handicap.
Le pari de l’open source et de la souveraineté
Underdog a choisi de rendre ses modèles accessibles au téléchargement. Cette décision s’inscrit dans une vision plus large défendue par son fondateur : créer des modèles open source, développés aux États-Unis, et destinés à redonner le contrôle aux utilisateurs. Dans un contexte où la concentration des capacités d’IA entre les mains de quelques acteurs soulève des questions de dépendance et de gouvernance, cette posture trouve un écho croissant.
La démocratisation de modèles performants capables de tourner localement pourrait également favoriser l’émergence de nouveaux usages. Des développeurs indépendants, des petites entreprises ou des associations peuvent désormais expérimenter sans devoir gérer des coûts d’infrastructure élevés. L’innovation n’est plus réservée à ceux qui disposent de clusters de GPU.
Vers une coexistence des modèles légers et massifs
Il ne s’agit pas d’opposer les deux approches. Les grands modèles continueront d’exceller dans les tâches complexes nécessitant une compréhension fine du langage ou une créativité poussée. En parallèle, les modèles légers occuperont le terrain des interactions quotidiennes, des appareils personnels et des contextes où la confidentialité prime. L’avenir de l’IA ressemblera probablement à un écosystème hybride dans lequel chaque type de modèle trouve sa place.
Underdog illustre parfaitement cette dualité. En sortant successivement Bark, Woof et un modèle de langage plus conséquent, la startup montre qu’il est possible de progresser sur plusieurs fronts à la fois. L’objectif n’est pas de battre les géants sur leur terrain, mais de prouver qu’une autre voie, plus sobre et plus respectueuse de l’utilisateur, est viable.
Ce que révèle cette démonstration sur l’état de l’IA
La sortie de Woof intervient à un moment où le débat sur la taille des modèles s’intensifie. Certains chercheurs et entrepreneurs commencent à remettre en question l’idée selon laquelle « plus grand est toujours mieux ». Les gains de performance apportés par l’augmentation du nombre de paramètres tendent à diminuer, tandis que les coûts énergétiques et financiers continuent d’augmenter. Dans ce contexte, les travaux sur la compression, la distillation et les architectures efficaces prennent une importance particulière.
Les démonstrations comme celle d’Underdog ont le mérite de rendre ces avancées tangibles. Voir un modèle de synthèse vocale fonctionner dans un simple navigateur, sans installation lourde, change la perception de ce qui est possible. Cela encourage d’autres équipes à explorer la même direction et accélère le mouvement vers une IA plus accessible.
Les défis qui restent à relever
Malgré l’enthousiasme, plusieurs obstacles demeurent. La qualité de la voix générée par un modèle aussi compact doit encore progresser pour convaincre un public large. Les accents, les émotions complexes et la prosodie naturelle restent des points délicats. De plus, l’écosystème autour de ces modèles légers doit se densifier : outils de fine-tuning, bibliothèques d’intégration, support multiplateforme.
La question de la distribution et de la découverte pose également problème. Comment un utilisateur moyen découvre-t-il et installe-t-il facilement un modèle open source de 32 Mo ? Les interfaces doivent rester simples, et les performances doivent être stables sur une large gamme d’appareils, y compris les smartphones d’entrée de gamme.
Une invitation à repenser nos priorités
Au-delà de la prouesse technique, la démonstration d’Underdog invite à une réflexion plus large. Pendant des années, l’industrie a valorisé la taille et la puissance brute. Aujourd’hui, d’autres critères remontent en surface : sobriété énergétique, respect de la vie privée, autonomie de l’utilisateur, accessibilité. Les modèles légers incarnent ces nouvelles priorités.
Pour les développeurs, cela signifie qu’il devient pertinent d’explorer des architectures plus frugales. Pour les utilisateurs, cela ouvre la possibilité de retrouver un certain contrôle sur les outils numériques qu’ils utilisent au quotidien. Et pour les entreprises, cela représente une opportunité de se différencier en proposant des solutions qui ne dépendent pas exclusivement du cloud.
Conclusion ouverte sur l’avenir de l’IA embarquée
Woof ne prétend pas révolutionner à lui seul le domaine de la synthèse vocale. En revanche, il prouve qu’un modèle de 32 Mo peut déjà offrir une expérience convaincante dans un navigateur. Combiné aux autres travaux d’Underdog, il dessine une trajectoire claire vers une IA plus locale, plus privée et potentiellement plus durable.
Dans les mois qui viennent, d’autres acteurs devraient suivre cette voie. Les progrès en compression de modèles, en quantification et en architectures efficaces vont continuer d’accélérer. Un jour peut-être, la plupart des interactions vocales courantes se dérouleront entièrement sur l’appareil, sans qu’aucune donnée ne quitte jamais votre téléphone ou votre ordinateur. Ce jour-là, on se souviendra peut-être de ces premières démonstrations qui montraient qu’il était possible de faire autrement.
En attendant, la machine à écrire rétro d’Underdog continue de parler. Et chaque mot qu’elle prononce rappelle qu’une autre intelligence artificielle est possible, plus discrète, plus légère, et résolument tournée vers l’utilisateur.